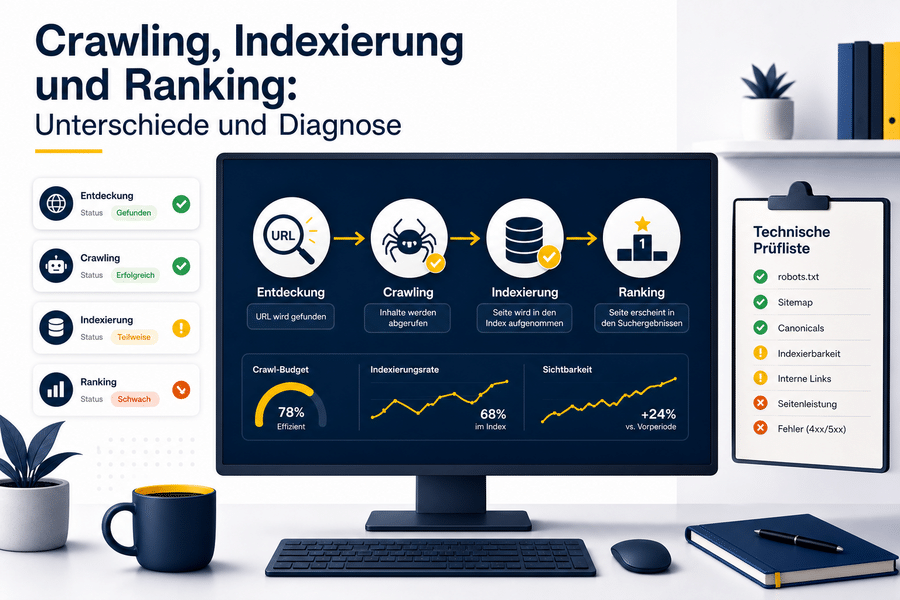
Eine Seite erscheint nicht bei Google. Doch liegt es am Crawling, an der Indexierung oder am Ranking? Diese Unterscheidung ist entscheidend, weil jede Prozessstufe andere Ursachen und Maßnahmen hat. Ein Indexierungsantrag löst beispielsweise kein Qualitätsproblem, während neue Inhalte kaum ranken können, wenn Google ihre URL noch nicht abgerufen hat.
Die Kurzfassung: Beim Crawling ruft Google eine bekannte URL ab. Bei der Indexierung entscheidet Google, ob und in welcher Form der Inhalt in den Suchindex aufgenommen wird. Beim Ranking wird eine indexierte Seite für eine konkrete Suchanfrage bewertet und gegebenenfalls ausgeliefert.
Crawling, Indexierung und Ranking klar unterscheiden
Crawling bedeutet, dass ein Crawler wie der Googlebot eine URL aufruft und ihre Ressourcen abruft. Google kann die Adresse zuvor über interne oder externe Links, eine XML-Sitemap, einen Redirect oder andere Quellen entdeckt haben. Entdeckung und Crawling sind deshalb nicht dasselbe: Eine URL kann Google bekannt sein, ohne bereits abgerufen worden zu sein.
Nach dem Abruf verarbeitet Google die Seite. Dazu kann das Rendering gehören, bei dem unter anderem JavaScript ausgeführt und die gerenderte Darstellung ausgewertet wird. Anschließend entscheidet Google, ob der Inhalt indexiert wird und welche URL als kanonische Version gelten soll. Eine technisch indexierbare Seite wird dabei nicht automatisch tatsächlich indexiert.
Erst danach kommt das Ranking: Für jede Suchanfrage bewertet Google, ob eine indexierte Seite relevant und geeignet ist. Eine URL kann daher vollständig indexiert sein, aber für Dein gewünschtes Keyword nicht auf einer praktisch sichtbaren Position erscheinen. Der fehlende Treffer ist dann kein Indexierungsfehler, sondern ein Ranking- oder Suchintensionsproblem. Die ausführlichen Grundlagen findest Du bei Crawling im Detail und zur Indexierung bei Google.
KAREON analysiert, ob Technik, Indexierungssteuerung, Inhalte oder Rankings die Sichtbarkeit Deiner Website begrenzen. Du erhältst eine nachvollziehbare Priorisierung statt ungezielter Einzelmaßnahmen.
So läuft der Weg in die Google-Suche ab
Der Prozess ist keine starre Fließbandkette, bei der jede URL automatisch alle Stufen durchläuft. Google kann Schritte wiederholen, Inhalte neu bewerten oder eine URL bewusst nicht weiterverarbeiten. Vereinfacht ergibt sich nach der offiziellen Darstellung zur Funktionsweise der Google-Suche folgende Reihenfolge:
- URL-Entdeckung: Google erfährt, dass eine Adresse existiert, etwa durch einen internen Link oder eine Sitemap.
- Crawling: Googlebot fordert die URL an und erhält beispielsweise HTML, einen Redirect oder einen HTTP-Fehler.
- Verarbeitung und Rendering: Google analysiert den abgerufenen Inhalt und kann für die Darstellung benötigte Ressourcen sowie JavaScript verarbeiten.
- Indexierung: Google bewertet Inhalt, Duplikate, Robots-Anweisungen und Canonical-Signale. Eine geeignete Version kann in den Index aufgenommen werden.
- Auslieferung und Ranking: Bei einer Suchanfrage werden passende indexierte Dokumente bewertet und in einer bestimmten Reihenfolge angezeigt.
Diese Abfolge erklärt zwei häufige Fälle. Eine URL kann gecrawlt, aber nicht indexiert sein, etwa bei sehr ähnlichen Inhalten, einer Soft-404-Bewertung oder geringem eigenständigen Mehrwert. Sie kann außerdem indexiert sein, ohne relevant zu ranken, wenn andere Seiten die Suchintention besser erfüllen oder stärkere Signale besitzen.
Rendering ist nicht bei jeder Seite gleich problematisch. Kritisch wird es, wenn wesentliche Inhalte, interne Links oder Robots-Anweisungen erst durch fehlerhaftes JavaScript entstehen oder benötigte Ressourcen für Google nicht erreichbar sind.
Eine URL in fünf Minuten richtig einordnen
Beginne mit der frühesten ungeklärten Prozessstufe. Ein fehlender Indexstatus bedeutet nicht automatisch, dass Google die URL überhaupt nicht kennt: Die vollständige Einordnung ergibt sich meist erst aus URL-Prüfung, interner Verlinkung, Sitemap, Berichten und gegebenenfalls Serverdaten.
- 1. URL-Prüfung öffnen: Prüfe, ob Google eine indexierte Version kennt und welche kanonische URL Google ausgewählt hat.
- 2. Wenn nicht indexiert: Lies zuerst den konkreten Ausschlussgrund. Bei noindex, Canonical oder Soft-404 ist ein erneuter Indexierungsantrag nicht die Lösung.
- 3. Live-Test ausführen: Prüfe Abrufbarkeit, Ressourcen und gerenderte Inhalte. Ein erfolgreicher Test bestätigt keine Indexierung.
- 4. Muster im Seitenindexierungsbericht prüfen: Betrifft der Status viele ähnliche URLs, suche nach einer gemeinsamen technischen oder inhaltlichen Ursache.
- 5. Erst bei bestätigter Indexierung Rankings prüfen: Nutze dann den Leistungsbericht und bewerte Suchintention, Inhalte sowie interne Verlinkung.
Der Live-Test zeigt, ob Google die aktuelle Version grundsätzlich abrufen und verarbeiten kann. Er bestätigt jedoch nicht, dass genau diese Version bereits im Index gespeichert ist oder später aufgenommen wird. Bei einer neuen einzelnen URL kann ein ausstehender Crawl normal sein; bei vielen wichtigen URLs mit demselben Status sollte Du technische und strukturelle Ursachen prüfen.
Server-Logfiles ergänzen die Search Console. Ein Abruf ist erst dann ein belastbarer Crawlingnachweis, wenn der Googlebot nach der von Google vorgesehenen Reverse- und Forward-DNS-Prüfung verifiziert wurde. Ein bloßer User-Agent mit der Bezeichnung Googlebot genügt nicht. Auch eine site:-Abfrage ist kein vollständiger Indexbericht.
| Prozessstufe | Typisches Symptom | Zuverlässige Prüfung | Mögliche Ursache | Passende Maßnahme |
|---|---|---|---|---|
| Entdeckung | URL ist möglicherweise noch nicht ausreichend bekannt | Interne Links, Sitemap, URL-Prüfung und Berichte gemeinsam bewerten | Verwaiste Seite, neue URL, fehlende Sitemap | Intern verlinken und Sitemap aktualisieren |
| Crawling | URL wurde gefunden, aber noch nicht abgerufen | URL-Prüfung, robots.txt und verifizierte Server-Logs | Sperre, Serverproblem, schwache Einbindung | Zugriff ermöglichen und technische Fehler beheben |
| Verarbeitung | Live-Seite und Google-Ansicht unterscheiden sich | Live-Test und gerendertes HTML | JavaScript- oder Ressourcenfehler | Wichtige Inhalte zuverlässig ausliefern |
| Indexierung | Gecrawlt, aber nicht im Index | URL-Prüfung und Seitenindexierungsbericht | noindex, Duplikat, Soft-404, schwacher Inhalt | Ursache statt nur den Status korrigieren |
| Ranking | URL ist indexiert, aber kaum sichtbar | Leistungsbericht und Inhaltsanalyse | Falsche Suchintention, Konkurrenz, interne Kannibalisierung | Inhalt, Relevanz und interne Verlinkung verbessern |
Prüfe zuerst die konkrete URL im URL-Prüftool. Danach betrachtest Du im Seitenindexierungsbericht, ob das Problem nur eine einzelne Adresse oder eine größere Gruppe mit gleichem Muster betrifft. Der Leistungsbericht ist erst sinnvoll, wenn die URL indexiert ist; bei neuen Seiten oder sehr niedrigen Positionen können wenige Impressionen und zeitverzögerte Daten die Aussagekraft begrenzen.
Die Google Search Console verbindet diese Prüfungen in einem Werkzeug. Einzelbefunde solltest Du dennoch immer im Zusammenhang deuten: Ein technisches Signal erklärt nicht automatisch, warum eine Seite für eine bestimmte Suchanfrage nicht sichtbar ist.
Ein erfolgreicher Live-Test bedeutet nur, dass die getestete Version aktuell erreichbar und grundsätzlich verarbeitbar ist. Er ersetzt nicht die Prüfung des gespeicherten Indexstatus und garantiert keine Aufnahme in den Index.
Search-Console-Meldungen richtig interpretieren
Die Statusmeldung Gefunden – zurzeit nicht indexiert bedeutet laut Google, dass die URL bekannt ist, aber noch nicht gecrawlt wurde. Häufig lohnt sich deshalb ein Blick auf interne Verlinkung, Sitemap-Einträge, Serverstabilität und die Menge wenig relevanter URLs. Bei einer einzelnen neuen Seite kann schlicht noch Zeit erforderlich sein.
Gecrawlt – zurzeit nicht indexiert liegt eine Stufe später: Google hat die Seite besucht, sie aber nicht in den Index aufgenommen. Jetzt sind reine Entdeckungsmaßnahmen nicht mehr der Kern des Problems. Prüfe stattdessen, ob der Inhalt eigenständig und nützlich ist, ob Google eine andere kanonische URL gewählt hat, ob eine Soft-404-Bewertung plausibel ist und ob die Seite zur Aufgabe Deiner Website passt.
Die offiziellen Erläuterungen zu beiden Meldungen stehen im Bericht zur Seitenindexierung. Bei noindex, einer abweichend gewählten kanonischen URL, einem Soft-404-Fall oder offensichtlich dünnem Inhalt bringt wiederholtes Einreichen nichts. Korrigiere zuerst das zugrunde liegende Signal oder den Inhalt.
Ein Indexierungsantrag im URL-Prüftool kann Google auf eine neue oder wesentlich geänderte URL aufmerksam machen. Er ist jedoch keine Freigabe für den Index und ersetzt keine klare interne Verlinkung, technische Erreichbarkeit oder eigenständigen Inhalt.
robots.txt, noindex, Canonical oder Redirect?
Diese Mittel sind nicht austauschbar. Sie lösen unterschiedliche Aufgaben und können sich bei falscher Kombination gegenseitig behindern.
| Mittel | Hauptzweck | Wirkung | Typische Fehlanwendung |
|---|---|---|---|
| robots.txt | Crawler-Zugriff steuern | Kann das Crawling bestimmter Pfade verhindern | Als sichere Entfernung aus dem Index verwendet |
| noindex | Indexierung einer erreichbaren Seite verhindern | Google kann die URL nach Verarbeitung aus dem Index ausschließen | Gleichzeitig per robots.txt gesperrt |
| Canonical | Bevorzugte Version ähnlicher Seiten signalisieren | Bündelt Signale auf einer kanonischen URL; bleibt ein Hinweis | Für gelöschte oder völlig andere Inhalte eingesetzt |
| 301-Redirect | URL dauerhaft auf eine andere Adresse weiterleiten | Nutzer und Crawler erreichen die Ziel-URL | Weiterleitung auf eine unpassende Start- oder Kategorieseite |
Eine robots.txt-Sperre verhindert nicht zuverlässig, dass eine URL in Suchergebnissen auftaucht. Google kann die Adresse über Links kennen und sie gegebenenfalls ohne gecrawlten Seiteninhalt anzeigen. Soll eine öffentlich erreichbare Seite nicht indexiert werden, ist noindex das passende Signal. Dafür muss Google die Seite jedoch abrufen dürfen.
Ein Canonical passt zu gleichen oder sehr ähnlichen Varianten, die erreichbar bleiben sollen. Möchtest Du eine alte URL dauerhaft durch eine neue ersetzen, ist meist ein Redirect eindeutiger. Bei vertraulichen Inhalten genügt weder robots.txt noch noindex als Zugriffsschutz; dafür ist eine echte Authentifizierung erforderlich.
Sperrst Du eine URL in der robots.txt und setzt zugleich noindex, kann Google das noindex-Signal unter Umständen nicht abrufen. Entferne für eine gewünschte Deindexierung zunächst die Crawling-Sperre und stelle sicher, dass Google die Anweisung verarbeiten kann.
Bevor Du eine Direktive änderst, formuliere das gewünschte Endergebnis: Soll die URL abrufbar und indexiert sein, erreichbar aber nicht indexiert werden, durch eine andere Variante repräsentiert werden oder vollständig umziehen? Erst aus diesem Ziel ergibt sich das richtige Mittel.
Kontrolliere nach der Anpassung außerdem HTTP-Statuscode, interne Links, Sitemap und Canonical gemeinsam. Ein technisch korrektes Einzelsignal kann durch widersprüchliche Seitensignale abgeschwächt werden, etwa wenn eine umgeleitete URL weiterhin prominent intern verlinkt und in der Sitemap geführt wird. Vertiefend helfen die Ratgeber zur robots.txt, zum noindex-Tag und zum Canonical Tag.
Typische Fälle und die jeweils sinnvolle Maßnahme
Bei einer neuen Leistungsseite solltest Du zunächst prüfen, ob sie von einer relevanten bestehenden Seite intern verlinkt ist, einen erfolgreichen HTTP-Status liefert und in der Sitemap steht. Ist sie erreichbar und indexierbar, kannst Du einmalig eine Indexierung anstoßen. Danach ist Beobachtung sinnvoller als tägliches erneutes Einreichen.
Bei einer gecrawlten, aber nicht indexierten Seite vergleichst Du ihren tatsächlichen Mehrwert mit ähnlichen URLs der Website. Wiederholt sie nur allgemeine Aussagen, konkurriert sie mit einer fast identischen Seite oder wirkt sie wie eine leere Trefferseite, helfen zusätzliche Indexierungsanträge nicht. Dann sind Zusammenlegung, Ausbau, ein passender Canonical oder bewusstes noindex mögliche Konsequenzen.
Ein Unternehmen veröffentlicht hypothetisch eine neue Seite für eine regionale Beratungsleistung. Die URL steht in der Sitemap, besitzt aber keinen internen Link. Google entdeckt sie zwar, crawlt sie jedoch zunächst nicht. Ein Link aus der passenden Leistungsübersicht stärkt Entdeckung und Kontext. Nach dem Crawling kann Google die Seite indexieren. Für ein gutes Ranking muss sie anschließend die regionale Suchintention besser erfüllen als bestehende Alternativen; die Indexierung allein reicht dafür nicht.
Zeigt Google einen anderen Canonical als den vom Betreiber angegebenen, prüfst Du Ähnlichkeit, interne Verlinkung, Redirects, Sitemap und Canonical-Tags als Gesamtsystem. Google behandelt das Canonical als Signal, nicht als zwingenden Befehl. Widersprechen stärkere Signale Deiner Angabe, kann eine andere URL gewählt werden.
Bei Soft-404-Fällen liefert der Server häufig den Status 200, während der Inhalt wie eine Fehlerseite, eine leere Kategorie oder eine nicht vorhandene Leistung wirkt. Entscheide dann ehrlich: Gibt es einen sinnvollen Ersatz, leite gezielt weiter. Existiert keiner, ist ein korrekter Fehlerstatus oft besser als eine inhaltsarme Seite mit 200.
Wenn die URL indexiert ist, aber nicht rankt
Sobald die URL-Prüfung eine Indexierung bestätigt, solltest Du das Problem nicht weiter als Crawlingfehler behandeln. Prüfe im Leistungsbericht, ob die Seite Impressionen für verwandte Suchanfragen erhält. Wenige Impressionen können auf begrenzte Nachfrage, unklare thematische Relevanz oder eine noch schwache Position hinweisen.
Vergleiche danach die Suchintention: Erwartet die Suchanfrage eine Leistungsseite, einen Ratgeber, einen Vergleich, lokale Anbieter oder ein konkretes Produkt? Eine ausführliche Seite kann inhaltlich gut sein und trotzdem am Bedarf vorbeigehen. Prüfe außerdem, ob mehrere eigene URLs um dieselbe Suchanfrage konkurrieren und ob interne Links die wichtigste Zielseite klar hervorheben.
Wenn Indexierungssteuerung, Inhalte und interne Verlinkung zusammenspielen, hilft eine strukturierte SEO-Prüfung dabei, die wirkungsvollsten nächsten Schritte zu priorisieren.
Verbessere nicht nur die Häufigkeit eines Keywords. Entscheidend sind eine vollständige Antwort auf das Nutzerproblem, verständliche Struktur, fachliche Substanz, passende Seitenelemente und eine glaubwürdige Einordnung des Angebots. Technische Erreichbarkeit ist die Voraussetzung; Relevanz und Qualität bestimmen, ob daraus Sichtbarkeit entsteht.
Wenn mehrere Ursachen zusammentreffen, arbeite in Prozessreihenfolge: zuerst Erreichbarkeit und Statuscodes, dann Indexierungssteuerung und Seitenqualität, anschließend Suchintention, interne Verlinkung und Ranking-Signale. So vermeidest Du Optimierungen an Seiten, die Google in der gewünschten Form noch gar nicht verarbeitet.
Fazit
Crawling, Indexierung und Ranking beschreiben drei unterschiedliche Problemebenen. Eine verlässliche Diagnose beginnt deshalb nicht mit einem pauschalen Indexierungsantrag oder einer allgemeinen Content-Überarbeitung, sondern mit der Frage, welche Prozessstufe tatsächlich betroffen ist.
- Eine bekannte URL kann ungecrawlt, eine gecrawlte URL nicht indexiert und eine indexierte URL praktisch unsichtbar sein.
- URL-Prüfung, Seitenindexierungsbericht, Live-Test und verifizierte Server-Logs beantworten unterschiedliche Diagnosefragen.
- robots.txt, noindex, Canonical und Redirect lösen verschiedene Aufgaben und sollten nicht widersprüchlich kombiniert werden.
Wenn die Befunde nicht eindeutig zusammenpassen, kann KAREON bei der technischen und inhaltlichen Einordnung von Sichtbarkeitsproblemen unterstützen. Mehr zur SEO-Beratung erfahren →