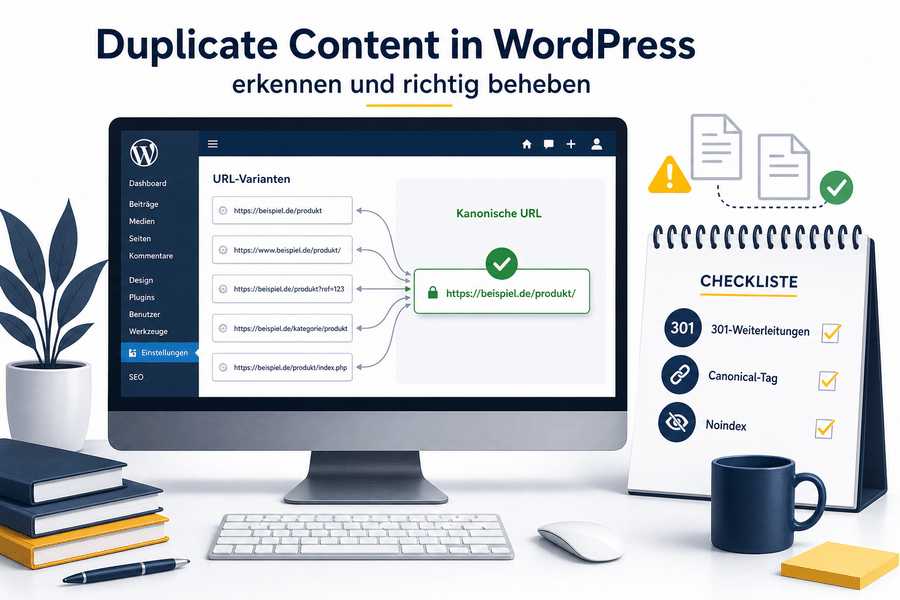
Duplicate Content in WordPress entsteht, wenn derselbe oder ein sehr ähnlicher Inhalt über mehrere URLs erreichbar ist. Typische Auslöser sind Archive, Parameter, Permalink-Varianten, kopierte Seiten oder uneinheitliche Domainvarianten. Das ist nicht automatisch ein SEO-Problem: Entscheidend ist, ob Suchmaschinen die gewünschte Haupt-URL eindeutig erkennen und ob mehrere Seiten um dieselbe Suchintention konkurrieren.
Dieser Ratgeber zeigt Dir einen klaren Ablauf: Du findest verdächtige URL-Cluster, prüfst technische und inhaltliche Signale und wählst anschließend zwischen 301-Weiterleitung, Canonical, Noindex oder einer inhaltlichen Zusammenführung. Auch Archive, Paginierungen, Staging-Systeme und typische Search-Console-Meldungen werden eingeordnet.
Duplicate Content beurteilen und erste Diagnose stellen
Von Duplicate Content spricht man, wenn identische oder weitgehend übereinstimmende Inhalte unter unterschiedlichen URLs abrufbar sind. Ein Beitrag kann etwa über seine reguläre Adresse, eine Parameter-Variante und eine alte Permalink-Struktur erreichbar sein. HTTP- und HTTPS-Versionen oder www- und Non-www-Varianten können sogar vollständige Duplikate einer Website erzeugen.
Davon zu unterscheiden sind normale Inhaltsüberschneidungen. Ein Kategoriearchiv darf dieselben Beiträge verlinken wie ein Schlagwortarchiv, ohne eine Kopie des Beitrags selbst zu sein. Relevant wird ein Archiv vor allem dann, wenn es kaum eigenen Nutzen bietet, überwiegend ähnliche Auszüge zeigt und mit anderen Übersichtsseiten um dieselben Suchanfragen konkurriert.
Doppelte Seitentitel sind ebenfalls nicht automatisch Duplicate Content. Zwei Seiten können denselben Title verwenden und dennoch unterschiedliche Inhalte haben. Umgekehrt können zwei URLs fast denselben Inhalt ausliefern, obwohl ihre Seitentitel abweichen.
Bewusst duplizierte WordPress-Entwürfe sind unkritisch, solange sie weder öffentlich erreichbar noch indexierbar sind. Erst eine veröffentlichte Kopie kann mit dem Original konkurrieren. Für die redaktionelle Seite des Themas hilft auch der Beitrag zu Fehlern beim Duplizieren in WordPress; allgemeine Grundlagen findest Du unter Duplicate Content.
Bei widersprüchlichen Canonicals, Weiterleitungen und Sitemap-Einträgen prüft KAREON die Ursache und die technisch passende Bereinigung. Du erhältst eine priorisierte Grundlage für die Umsetzung.
Typische WordPress-URLs und Ursachen systematisch prüfen
WordPress erzeugt neben Beiträgen und Seiten verschiedene Archivtypen. Dazu gehören Kategorien, Schlagwörter, Autoren- und Datumsarchive sowie individuelle Taxonomien oder Beitragsformate. Themes, Page Builder und Plugins können weitere URLs erzeugen, etwa Filteransichten, Vorlagen-URLs oder alternative Listenansichten.
Besonders in WooCommerce-Shops entstehen durch Produktkategorien, Sortierungen, Filter, Paginierungen und Kampagnenparameter viele Varianten. Technisch unterschiedliche URLs können dabei dieselbe Produktauswahl zeigen. Bei anderen Parametern verändert sich der sichtbare Inhalt tatsächlich, sodass nicht jede Variante als Duplikat behandelt werden darf.
Dass eine URL technisch existiert, bedeutet nicht automatisch, dass sie indexiert wird oder bereinigt werden muss. Prüfe Inhalt, Statuscode, Canonical, Indexierbarkeit, interne Verlinkung und Sitemap immer gemeinsam.
Beginne mit bekannten URL-Mustern: HTTP und HTTPS, www und Non-www, Varianten mit und ohne Slash, alte Permalinks, index.php-Varianten, Such-URLs, Medien-Anhangseiten, Archive, Parameter und paginierte Listen. WordPress leitet manche nicht kanonischen Adressen automatisch weiter. Serverregeln, Cache-Systeme oder Plugins können dennoch Varianten erzeugen, die mit Statuscode 200 erreichbar bleiben.
Ein Website-Crawler hilft, größere Muster zu erkennen. Filtere unter anderem nach identischen Titles, ähnlichen H1-Überschriften, Canonicals auf andere URLs, kurzen Archivseiten und indexierbaren Parameterseiten. Ergänze den Crawl durch manuelle Aufrufe der verdächtigen Varianten und prüfe, ob sie direkt weiterleiten oder eigenständig Inhalte ausliefern.
Kontrolliere bei jeder URL den HTTP-Status, das Canonical im HTML-Quellcode und gegebenenfalls Canonical-Angaben in HTTP-Headern. Prüfe außerdem Meta-Robots, X-Robots-Tag und robots.txt. Eine robots.txt-Sperre ist nicht dasselbe wie Noindex: Google muss eine Seite in der Regel abrufen können, um eine Noindex-Anweisung zu verarbeiten.
Search-Console-Meldungen richtig einordnen
Die Google Search Console ist ein sinnvoller Ausgangspunkt, aber kein Ersatz für den technischen Vergleich der URLs. Über den Bericht zur Seitenindexierung und die URL-Prüfung siehst Du, welche Seiten Google als Duplikate einordnet und welche kanonische Adresse Google ausgewählt hat. Eine Einführung bietet der Beitrag zur Google Search Console.
Die Meldung „Duplikat – vom Nutzer nicht als kanonisch festgelegt“ bedeutet zunächst: Google hat für diese URL kein vom Betreiber festgelegtes Canonical erkannt oder übernommen und selbst eine kanonische Adresse ausgewählt. Das beweist nicht automatisch, dass alle übrigen Signale unklar sind oder dass ein Fehler vorliegt. Prüfe, ob Googles Auswahl der URL entspricht, die Du tatsächlich im Index haben möchtest.
Bei „Google hat eine andere Seite als der Nutzer als kanonische Seite bestimmt“ weicht Googles Auswahl von Deinem angegebenen Canonical ab. Ursachen können eine unpassende Zielseite, inhaltliche Unterschiede, Weiterleitungen in eine andere Richtung, interne Links auf eine abweichende Variante oder Sitemap-Einträge für die falsche URL sein.
Search-Console-Statuswerte zu Duplikaten sind nicht automatisch Fehler. Handlungsbedarf besteht vor allem, wenn Google eine unerwünschte URL auswählt, mehrere Varianten indexiert bleiben oder konkurrierende Seiten dieselbe Suchintention bedienen.
Vergleiche für einen vollständigen Befund immer das URL-Paar oder den gesamten Cluster: Welcher Inhalt ist sichtbar? Welche URL antwortet mit 200? Wohin führen Redirects? Welches Canonical ist angegeben? Welche Adresse verlinkt die Website intern und welche steht in der XML-Sitemap? Erst diese Kombination zeigt, ob ein technischer Widerspruch oder lediglich eine legitime Alternativseite vorliegt.
Ein häufiger Problemfall lautet: URL A enthält ein Canonical auf URL B, die XML-Sitemap nennt A, interne Links zeigen auf URL C und B leitet zurück auf A. Einzelne Tags zu ändern reicht dann nicht aus. Der gesamte Cluster muss auf eine eindeutige Ziel-URL ausgerichtet werden.
301, Canonical, Noindex oder Zusammenführung auswählen
Die passende Maßnahme hängt vom Zweck der alternativen URL ab. Stelle vor jeder Änderung vier Fragen: Soll die URL für Nutzer erreichbar bleiben? Ist ihr Inhalt gleich oder nur ähnlich? Soll sie selbst Suchtraffic erzielen? Gibt es eine wirklich passende Ziel-URL?
| Prüffrage und Situation | Geeignete Maßnahme | Warum |
|---|---|---|
| Die Variante wird nicht mehr benötigt und es gibt eine gleichwertige Ziel-URL. | 301-Redirect | Nutzer und Suchmaschinen gelangen direkt zur endgültigen Adresse. |
| Die Alternative soll erreichbar bleiben und zeigt nahezu denselben Inhalt. | Canonical | Die Variante bleibt nutzbar, verweist aber auf die bevorzugte Index-URL. |
| Die Seite ist für Nutzer nützlich, soll aber keinen eigenen Suchindex-Eintrag erhalten. | Noindex | Die URL bleibt aufrufbar, wird aber nicht als Zielseite für die Suche vorgesehen. |
| Zwei Seiten bedienen dieselbe Suchintention und eine ist entbehrlich. | Inhalte zusammenführen und weiterleiten | Inhalte und Signale werden auf einer stärkeren Seite gebündelt. |
| Beide Seiten haben einen eigenständigen Zweck und unterschiedliche Suchintentionen. | Inhalte differenzieren | Beide URLs können mit selbstreferenziellen Canonicals indexierbar bleiben. |
Ein 301-Redirect ist passend, wenn eine alte Permalink-Struktur, eine Domainvariante oder eine veröffentlichte Seitenkopie keinen eigenen Zweck mehr hat. Leite möglichst direkt auf die endgültige, inhaltlich passende URL weiter und vermeide Weiterleitungsketten.
Ein Canonical Tag eignet sich für erreichbare Alternativen mit sehr ähnlichem Inhalt, etwa bestimmte Parameteransichten. Die Quellseite sollte möglichst direkt auf die endgültige kanonische URL verweisen, nicht auf eine URL, die ihrerseits weiterleitet oder ein weiteres Canonical setzt. Ein Canonical ist ein starkes Signal, aber keine Garantie für die Google-Auswahl.
Ein Noindex-Tag ist keine Standardlösung für veraltete oder vollständig doppelte URLs. Noindex entfernt eine Seite nicht wie ein Redirect aus einem URL-Cluster und konsolidiert deren Signale nicht in gleicher Weise auf ein Ziel. Nutze es deshalb vor allem für nützliche, aber nicht als Suchergebnis gewünschte Seiten. Noindex-Seiten sollten normalerweise auch nicht als indexierbare Zielseiten in der XML-Sitemap stehen.
Archive, Parameter und Paginierung differenziert behandeln
Kategoriearchive können wertvolle Einstiegsseiten sein, wenn sie ein klares Thema abdecken, sinnvoll kuratiert sind und eigenen Einführungstext bieten. Dann können sie indexierbar bleiben und ein selbstreferenzielles Canonical erhalten. Schlagwortarchive sind häufiger redundant, wenn Tags ungeplant vergeben wurden und viele dünne Übersichtsseiten entstehen.
Autorenarchive können bei mehreren sichtbaren Fachautoren nützlich sein. Bei nur einem Autor überschneiden sie sich oft mit der Beitragsübersicht. Datumsarchive haben auf vielen Unternehmensseiten wenig zusätzlichen Nutzen, können bei Nachrichten- oder Veranstaltungsportalen aber sinnvoll sein. Entscheidend ist stets der eigenständige Nutzen für Besucher und Suchanfragen.
- Tracking und Kampagnen: Parameter wie
?utm_ändern den Inhalt nicht. Interne Links und Sitemap sollten auf die saubere URL zeigen; ein Canonical kann die Haupt-URL unterstützen. - Sortierung: Prüfe Varianten wie
?orderby=. Wenn nur die Reihenfolge abweicht, ist meist keine eigenständige Suchzielseite nötig. - Filter: Prüfe, ob Filterparameter eine nützliche, eigenständige Auswahl schaffen. Andernfalls vermeide indexierbare Varianten ohne Suchwert.
- Paginierung: Seiten wie
/page/2/enthalten andere Listeneinträge und sind nicht automatisch Duplikate von Seite 1. Sie benötigen üblicherweise ein selbstreferenzielles Canonical. - Session-IDs: Entferne oder konsolidiere Sitzungsparameter, wenn sie identische Inhalte unter vielen URLs erzeugen.
- Suche und Anhänge: Interne Suchergebnisse und reine Medien-Anhangseiten benötigen häufig keinen eigenen Suchindex-Eintrag.
Bei WooCommerce-Filtern ist besondere Vorsicht sinnvoll. Manche Kombinationen können eine echte Landingpage mit Suchwert darstellen, andere erzeugen nur viele technisch crawlbare Varianten. Lege bewusst fest, welche Filterseiten indexierbar sein sollen, und verlinke intern bevorzugt auf die freigegebenen Ziel-URLs.
Verweise bei Paginierungen nicht pauschal mit Canonical auf Seite 1. Folgeseiten zeigen andere Produkte oder Beiträge und sind deshalb nicht identisch. Klare Vor- und Zurückverlinkungen helfen Google beim Crawling der Listenstruktur.
Kopierte Seiten, Vorlagen und Staging-Systeme absichern
Veröffentlichte Seitenkopien solltest Du nicht lediglich über einen anderen Title unterscheiden. Wenn Original und Kopie dieselbe Suchintention bedienen, führe die relevanten Inhalte zusammen und leite die entbehrliche URL weiter. Soll die Kopie später eine eigenständige Landingpage werden, benötigt sie bis zur Veröffentlichung einen nicht öffentlichen Status oder einen verlässlichen Indexierungsschutz.
Bei Page Buildern ist zwischen einer internen Vorlage und einer öffentlich erreichbaren URL zu unterscheiden. Eine Vorlage im Backend ist in der Regel kein SEO-Problem. Kritisch wird sie, wenn das System dafür eine indexierbare Frontend-Adresse mit kopiertem Inhalt ausgibt.
Eine WordPress-Einstellung, die Suchmaschinen von der Indexierung abhalten soll, ist kein Zugangsschutz für ein Staging-System. Sichere Entwicklungsumgebungen vorzugsweise durch Authentifizierung oder serverseitige Zugriffsbeschränkungen ab.
Kontrolliere vor dem Livegang außerdem Demo-Seiten, Testprodukte, Vorlagen-URLs und importierte Inhalte. Nach einem Domainwechsel müssen Canonicals, interne Links, strukturierte Daten und XML-Sitemaps auf die Produktionsdomain verweisen. Entferne zugleich unbeabsichtigte Noindex-Anweisungen aus der Entwicklungsumgebung.
Signale im gesamten URL-Cluster vereinheitlichen
Nach der Bereinigung sollte jede relevante URL-Gruppe eine klar erkennbare Hauptadresse besitzen. Diese Ziel-URL antwortet mit Status 200, verwendet nach Möglichkeit ein selbstreferenzielles Canonical, ist intern verlinkt und steht in der XML-Sitemap. Nicht gewünschte Varianten leiten weiter, tragen ein passendes Canonical oder sind bewusst auf Noindex gesetzt.
Prüfe dabei Navigationslinks, Breadcrumbs, Links in Beiträgen, hreflang-Angaben, strukturierte Daten, Canonicals, Weiterleitungen und Sitemap-Einträge. Wenn die Website weiterhin an mehreren Stellen auf alte Varianten verweist, wird Google sie länger crawlen und die gewünschte Konsolidierung möglicherweise weniger eindeutig bewerten.
Ein typischer Vorher-nachher-Fall ist eine Produktkategorie, die zusätzlich über eine Tracking-URL, eine Sortieransicht und eine alte HTTP-Variante erreichbar ist. Nach der Bereinigung bleibt die gewünschte HTTPS-Kategorie mit Status 200 bestehen. Alte Domainvarianten leiten direkt dorthin, Trackingvarianten verweisen auf die saubere Haupt-URL und nur diese steht in Sitemap und interner Navigation.
Wenn mehrere URL-Typen betroffen sind, hilft eine strukturierte Prüfung, Fehlweiterleitungen und unbeabsichtigte Deindexierungen zu vermeiden. Ein technischer SEO-Check kann Ursache und Reihenfolge der Maßnahmen klären.
Erfolg nach der Bereinigung kontrollieren
Starte nach den Änderungen einen neuen Crawl und vergleiche ihn mit dem Ausgangszustand. Prüfe repräsentative Ziel- und Alternativ-URLs statt nur einzelne zufällige Seiten. Bei umfangreichen Websites kann diese Kontrolle Teil eines vollständigen SEO-Audits sein.
Für jeden bereinigten Cluster sollten die technischen Prüfkriterien zusammenpassen:
- Die gewünschte Ziel-URL antwortet mit Status 200.
- Eine nicht benötigte Alternative führt mit genau einer 301-Weiterleitung direkt zum Ziel.
- Das Canonical der Zielseite verweist auf sich selbst.
- Nur die gewünschte indexierbare Ziel-URL steht in der XML-Sitemap.
- Interne Links verweisen auf die Ziel-URL statt auf alte Varianten.
- Die URL-Prüfung der Search Console zeigt langfristig die gewünschte Google-canonical-Auswahl.
Nutze die URL-Prüfung für repräsentative Beispiele aus jedem Muster: Domainvarianten, Parameter, Archive und alte URLs. Google muss Änderungen zunächst erneut crawlen und verarbeiten. Wiederholte technische Änderungen ohne neue Prüfdaten machen die Bewertung schwieriger.
Erfolg bedeutet nicht, dass jede ausgeschlossene URL vollständig aus der Search Console verschwindet. Entscheidend ist, dass wichtige Zielseiten indexiert bleiben, unerwünschte Varianten korrekt zugeordnet werden und keine wertvollen Einstiegsseiten versehentlich verloren gehen.
Fazit
Duplicate Content in WordPress lässt sich zuverlässig lösen, wenn Du nicht pauschal Einstellungen setzt, sondern jeden URL-Cluster nach Ursache und Zweck bewertest. Archive und ausgeschlossene Duplikate sind nicht automatisch problematisch; wichtig sind eine passende Maßnahme und konsistente technische Signale.
- Vergleiche verdächtige URLs anhand von Inhalt, Statuscode, Canonical, Indexierbarkeit, internen Links und Sitemap.
- Wähle 301, Canonical, Noindex oder eine Zusammenführung danach, ob die URL erreichbar bleiben und selbst Suchtraffic erzielen soll.
- Kontrolliere die Bereinigung mit einem neuen Crawl und der URL-Prüfung in der Search Console.
Bei komplexen WordPress-URL-Strukturen kann KAREON bei Diagnose und technischer Bereinigung unterstützen. Unverbindlich Kontakt aufnehmen.