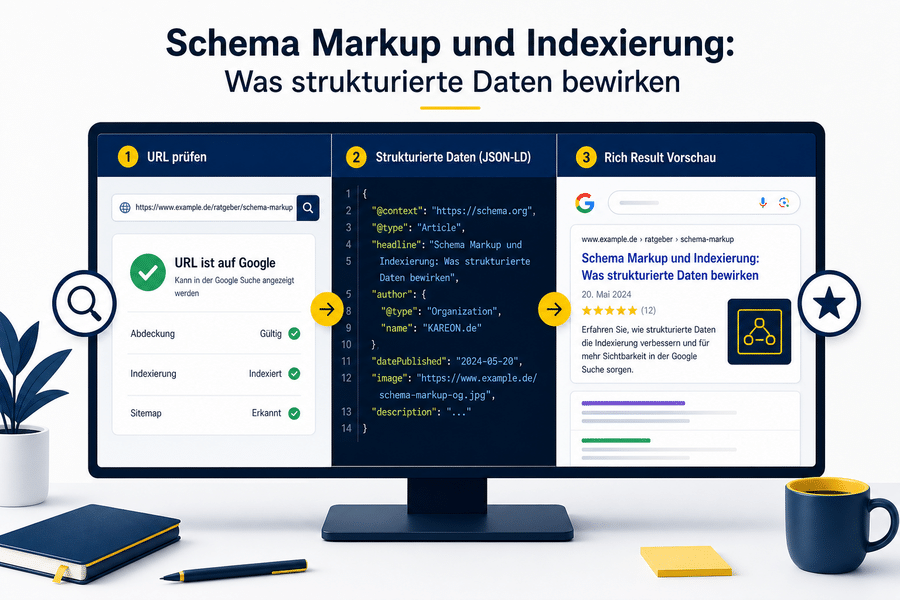
Schema Markup kann Google helfen, den Inhalt und die Bedeutung einer Seite präziser zu verstehen. Eine nicht indexierte URL gelangt dadurch jedoch nicht automatisch in den Google-Index. Strukturierte Daten lösen weder eine Crawling-Sperre noch ein noindex, einen ungeeigneten Canonical Tag oder grundlegende Qualitätsprobleme.
Ihr eigentlicher Nutzen liegt an anderer Stelle: Passendes Markup beschreibt Entitäten, Seitentypen und Beziehungen maschinenlesbar. Dadurch kann eine indexierbare Seite für bestimmte erweiterte Suchdarstellungen infrage kommen. Dieser Ratgeber zeigt Dir, wie Du Indexierung, Ranking und Rich Results auseinanderhältst, einen geeigneten Schema-Typ auswählst, JSON-LD einbindest und technische Fehler systematisch diagnostizierst.
Kann Schema Markup eine Seite in den Google-Index bringen?
Nein, Schema Markup ist kein Indexierungshebel im engeren Sinn. Es kann weder die Aufnahme einer URL in den Index erzwingen noch eine Indexierungsanfrage ersetzen. Google muss die URL zunächst finden, abrufen, rendern und als indexierungswürdig sowie kanonisch relevant einstufen.
Strukturierte Daten werden erst dann praktisch wirksam, wenn Google auf den Seiteninhalt zugreifen und das Markup verarbeiten kann. Ist eine URL durch noindex von der Indexierung ausgeschlossen, wegen einer robots.txt-Regel nicht crawlbar oder auf eine andere URL kanonisiert, behebt ein korrektes BlogPosting– oder Product-Markup diesen Zustand nicht.
Auch eine erfolgreiche Validierung bedeutet nicht, dass die Seite indexiert wird, besser rankt oder ein Rich Result erhält. Sie bestätigt zunächst nur, dass das geprüfte Markup technisch lesbar ist beziehungsweise die kontrollierten Anforderungen erfüllt. Wenn Dein eigentliches Problem eine fehlende Aufnahme in die Suche ist, musst Du die Indexierung gezielt optimieren.
Wenn unklar ist, ob Markup, Crawling oder die Seitenarchitektur das Problem verursacht, sollte die URL als Ganzes geprüft werden. KAREON unterstützt Dich bei der technischen Analyse und einer passenden Implementierung.
Crawling, Indexierung, Ranking und Rich Results sind verschiedene Ebenen
Viele Fehlentscheidungen entstehen, weil mehrere Prozesse unter dem Begriff „bei Google sichtbar werden“ zusammengefasst werden. Für eine belastbare Diagnose solltest Du vier Ebenen getrennt betrachten.
| Ebene | Was passiert? | Rolle von Schema Markup |
|---|---|---|
| Crawling | Googlebot entdeckt und ruft eine URL ab. | Markup ersetzt weder interne Links, Sitemaps noch einen erlaubten Abruf. |
| Indexierung | Google verarbeitet die Seite und entscheidet über die Aufnahme in den Index. | Strukturierte Daten können das Inhaltsverständnis unterstützen, erzwingen aber keine Aufnahme. |
| Ranking | Google ordnet indexierte Dokumente für eine konkrete Suchanfrage. | Gültiges Markup ist keine pauschale Rankinggarantie. |
| Rich Result | Ein Suchergebnis erhält eine besondere Darstellung oder zusätzliche Elemente. | Unterstütztes und richtlinienkonformes Markup kann eine Seite dafür berechtigen. |
Die praktische Prüfregel lautet: Google kann strukturierte Daten erkennen, ohne dass die Seite für eine Suchfunktion geeignet ist. Eine Seite kann für eine Suchfunktion geeignet sein, ohne dass Google diese Darstellung tatsächlich ausspielt. Und eine nicht indexierte URL kann trotz technisch korrektem Markup in der Suche fehlen.
Ein Rich Result ist außerdem nicht mit jedem optisch auffälligen Suchergebnis gleichzusetzen. Google kann Titel, Beschreibung und andere Bestandteile eines normalen Snippets unabhängig von strukturierten Daten zusammenstellen. Wie sich die Prozesse technisch unterscheiden, erklärt der Überblick zu Crawling, Indexierung und Ranking.
Was Schema Markup tatsächlich leisten kann
Schema Markup übersetzt sichtbare Informationen in ein standardisiertes Vokabular. So kann beispielsweise kenntlich gemacht werden, dass eine Zeichenfolge der Name einer Organisation ist, ein Datum die Veröffentlichung eines Artikels bezeichnet oder eine Navigationsfolge eine Breadcrumb-Struktur darstellt.
Richtig eingesetzt unterstützt Markup vor allem drei Ziele: ein klareres Inhaltsverständnis, die grundsätzliche Berechtigung für bestimmte Suchfunktionen und eine konsistente Ausgabe wiederkehrender Daten wie Autor, Preis, Verfügbarkeit oder Veranstaltungsdatum.
Schema.org stellt ein umfangreiches Vokabular bereit. Google verwendet daraus jedoch nur ausgewählte Typen und Eigenschaften für besondere Suchdarstellungen. In der aktuellen Google Search Gallery sind beispielsweise Suchfunktionen für Artikel, Breadcrumbs, Organisationen, lokale Unternehmen, Produkte, Rezensionen, Rezepte, Veranstaltungen, Stellenanzeigen, Videos, Datensätze, Diskussionsforen, Profilseiten, Frage-Antwort-Seiten und Ferienunterkünfte dokumentiert.
Ein Schema.org-Typ kann formal gültig sein, ohne von Google für ein Rich Result unterstützt zu werden. Prüfe deshalb nicht nur das Vokabular, sondern immer auch die aktuelle Search Gallery und die Dokumentation der gewünschten Suchfunktion.
Der Schema.org Validator kann einen solchen Typ als korrekt bewerten, während der Rich Results Test keine unterstützte Darstellung erkennt. Das ist kein Widerspruch: Der Validator prüft die Verwendung des allgemeinen Vokabulars, der Rich Results Test prüft Google-spezifische Suchfunktionen.
Mehr Markup bedeutet nicht automatisch mehr Sichtbarkeit. Der Nutzen entsteht, wenn der Typ zum Hauptinhalt passt, die ausgezeichneten Daten sichtbar und aktuell sind und Google die Funktion für diesen Seitentyp unterstützt.
Den passenden Schema-Typ und das richtige Format auswählen
Der Typ sollte den sichtbaren Hauptinhalt der konkreten URL beschreiben. Eine redaktionelle Ratgeberseite kann etwa mit Article oder dem spezifischeren BlogPosting ausgezeichnet werden. Eine Kategorieseite wird nicht allein deshalb zu einem Produkt, weil sie mehrere Produkte verlinkt. Eine Breadcrumb-Navigation lässt sich ergänzend als BreadcrumbList ausgeben.
Bewerte mögliche Typen anhand von sechs Fragen: Entspricht der Typ dem primären Zweck der Seite? Sind die Angaben für Besucher sichtbar? Unterstützt Google eine passende Suchfunktion? Lassen sich erforderliche Eigenschaften zuverlässig liefern? Bleiben dynamische Werte aktuell? Und rechtfertigt der erwartbare Nutzen den Pflegeaufwand?
Für die technische Einbindung stehen JSON-LD, Microdata und RDFa zur Verfügung. Google kann alle drei Formate verarbeiten, empfiehlt in seiner Einführung zu strukturierten Daten jedoch JSON-LD, sofern es für die jeweilige Implementierung geeignet ist.
Das Markup muss den sichtbaren Seiteninhalt wahrheitsgemäß abbilden. Versteckte, irreführende oder nicht zur Seite passende Angaben können gegen Googles Richtlinien für strukturierte Daten verstoßen.
JSON-LD wird als separater Datenblock ausgegeben und ist meist leichter zu entwickeln, zu prüfen und zu warten. Microdata und RDFa ergänzen Eigenschaften direkt im HTML und können sinnvoll sein, wenn ein bestehendes System bereits darauf basiert. Für Navigationspfade findest Du eine konkrete Anwendung in den Best Practices für Breadcrumbs.
JSON-LD korrekt in Website oder WordPress einbinden
JSON-LD wird üblicherweise in einem Datenblock vom Typ application/ld+json ausgegeben. Dieser kann sich im head oder body befinden. Entscheidend ist, dass er in der von Google abgerufenen und gerenderten Seite vorhanden ist und mit dem sichtbaren Inhalt übereinstimmt.
Ein minimales BlogPosting-Markup beschreibt zunächst nur die grundlegende Einordnung als Artikel:
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "BlogPosting",
  "headline": "Beispielartikel",
  "datePublished": "2026-01-01"
}
</script>
Eine vollständigere, konsistent gepflegte Variante kann zusätzliche Informationen zur kanonischen Artikelseite, zum Bild, zur Aktualisierung und zum Herausgeber liefern:
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "BlogPosting",
  "headline": "Beispielartikel",
  "mainEntityOfPage": "https://www.beispiel.de/beispielartikel/",
  "image": "https://www.beispiel.de/bild.jpg",
  "datePublished": "2026-01-01",
  "dateModified": "2026-01-01",
  "author": {
    "@type": "Organization",
    "name": "Beispielunternehmen"
  },
  "publisher": {
    "@type": "Organization",
    "name": "Beispielunternehmen"
  }
}
</script>mainEntityOfPage, image, dateModified und publisher können Google bei der Einordnung helfen oder für Anforderungen einer Suchfunktion relevant sein. Sie heben aber weder ein noindex auf noch umgehen sie robots.txt, Canonical-Entscheidungen oder Qualitätsbewertungen. Der erweiterte Block verbessert also die Beschreibung, nicht die grundsätzliche Indexierbarkeit.
In WordPress gibt es drei übliche Wege: Ein SEO- oder Schema-Plugin erzeugt die Daten aus gepflegten Feldern, ein Theme oder Child-Theme gibt sie templategesteuert aus oder eine individuelle Integration nutzt das bestehende Inhaltsmodell. Achte besonders auf doppelte Ausgaben: SEO-Plugin, Theme, WooCommerce und ein separates Schema-Plugin können gleichzeitig Markup erzeugen und dadurch widersprüchliche Haupttypen, Autoren oder Organisationsdaten liefern.
Angenommen, ein WordPress-Beitrag wird als
BlogPosting markiert. Das Veröffentlichungsdatum im Markup lautet 28. Oktober, auf der Seite ist aber 25. Oktober sichtbar. Die JSON-LD-Syntax kann trotzdem korrekt sein, inhaltlich bleibt die Ausgabe widersprüchlich. Sinnvoll ist eine gemeinsame Datenquelle für sichtbaren Inhalt und Markup.
Wird JSON-LD erst durch JavaScript erzeugt, ist nicht allein der sichtbare Browserzustand maßgeblich. Entscheidend ist, ob Google die Daten beim Abruf und Rendering tatsächlich erhält. Fehlerhafte Skripte, verzögert geladene Daten oder erst nach einer Nutzerinteraktion eingefügte Blöcke können dazu führen, dass Testwerkzeuge, Googlebot und Browseransicht unterschiedliche Ergebnisse zeigen.
Schema Markup testen und Fehler systematisch diagnostizieren
Eine reine Quelltextkontrolle reicht nicht aus. Ein sinnvoller Prüfprozess verbindet Indexierbarkeit, technische Validierung, Google-spezifische Anforderungen und die tatsächlich gerenderte Live-Seite.
- Prüfe in der URL-Prüfung, ob die URL indexiert und für Google abrufbar ist.
- Bestimme den sichtbaren Hauptinhalt und den fachlich passenden Schema-Typ.
- Kontrolliere in der Search Gallery, ob Google dafür eine Suchfunktion unterstützt.
- Erstelle vorzugsweise wartbares JSON-LD aus denselben Daten wie den sichtbaren Inhalt.
- Teste die Rich-Result-Eignung und validiere das allgemeine Vokabular zusätzlich.
- Kontrolliere die Live-URL sowie das gerenderte HTML, besonders bei JavaScript-Ausgabe.
- Überwache nach dem erneuten Crawling Indexierungs- und Rich-Result-Berichte.
Der Rich Results Test untersucht, ob Google unterstützte strukturierte Daten erkennt und welche Probleme für die jeweilige Suchfunktion bestehen. Der Schema.org Markup Validator prüft dagegen die Verwendung des allgemeinen Schema.org-Vokabulars in JSON-LD, RDFa oder Microdata. Die URL-Prüfung und die Statusberichte der Google Search Console beantworten wiederum Fragen zur konkreten URL und zu Problemen auf Website-Ebene.
| Befund | Typische Ursache | Passende Maßnahme |
|---|---|---|
| URL ist durch robots.txt gesperrt | Googlebot darf die URL nicht abrufen oder nicht vollständig rendern. | robots.txt-Regel prüfen und nur ändern, wenn die URL crawlbar sein soll. |
URL enthält noindex |
Meta-Robots-Angabe oder HTTP-Header schließt die Indexierung aus. | noindex nur entfernen, wenn die URL indexiert werden soll. |
| Google wählt eine andere Canonical URL | Duplikate oder widersprüchliche Canonical-Signale verweisen auf eine andere Fassung. | Kanonisierung, interne Links und Markup auf der bevorzugten URL prüfen. |
| Markup fehlt im Test | JSON-LD ist nicht parsbar, wird nur clientseitig erzeugt oder fehlt im gerenderten HTML. | Syntax, Live-Ausgabe und Rendering mit mehreren Werkzeugen kontrollieren. |
| Markup beschreibt unsichtbare Inhalte | Ausgezeichnete Angaben sind für Besucher nicht vorhanden oder weichen ab. | Inhalte sichtbar machen, Werte angleichen oder das Markup entfernen. |
| Pflichtfelder fehlen | Ein unterstützter Typ erfüllt Anforderungen der gewünschten Suchfunktion nicht. | Dokumentation prüfen und erforderliche, zutreffende Eigenschaften ergänzen. |
| Typ wird nicht als Rich Result erkannt | Der Schema.org-Typ ist gültig, aber von Google nicht für diese Suchfunktion unterstützt. | Kein Rich Result erwarten; nur passende, unterstützte Typen einsetzen. |
Kritische Fehler verhindern in der Regel die Berechtigung des betroffenen Elements für die jeweilige Suchfunktion. Warnungen betreffen häufig empfohlene oder optionale Angaben; das Element kann grundsätzlich weiterhin berechtigt sein, aber weniger vollständig interpretiert werden. Die konkrete Meldung ist immer entscheidend.
Davon zu unterscheiden sind nicht parsbare strukturierte Daten und manuelle Maßnahmen. Ein Parserproblem bedeutet, dass Google den Datenblock nicht zuverlässig lesen kann. Eine manuelle Maßnahme kann bei schwerwiegenden Richtlinienverstößen entstehen und wird in der Search Console separat behandelt.
Warum korrektes Markup ohne Rich Result bleiben kann
Ein fehlerfreier Test weist nur nach, dass die kontrollierten Voraussetzungen erfüllt sind. Google entscheidet weiterhin abhängig von Suchanfrage, Gerät, Standort, Seitenqualität und weiteren Systemsignalen, ob und wie ein erweitertes Ergebnis erscheint. Die Darstellung kann sich außerdem verändern, ohne dass Du das Markup angepasst hast.
Prüfe bei ausbleibenden Rich Results zunächst, ob der Typ tatsächlich unterstützt wird, alle erforderlichen Angaben vorhanden sind und die Daten sichtbar sowie aktuell bleiben. Kontrolliere anschließend, ob Google die richtige kanonische URL gewählt hat. Befindet sich das Markup nur auf einer Duplikat-URL, während Google eine andere Fassung indexiert, analysierst Du sonst die falsche Seite.
Falls bereits die Indexierung scheitert, konzentriere Dich auf HTTP-Status, robots.txt, Meta-Robots-Angaben, Canonical Tags, interne Verlinkung, Sitemap, Rendering und inhaltliche Eigenständigkeit. Eine ausführlichere Übersicht hilft Dir dabei, typische Indexierungsfehler zu erkennen.
Wenn Search Console, Validatoren und Live-Seite unterschiedliche Signale liefern, kann eine strukturierte Prüfung den tatsächlichen Engpass sichtbar machen.
Nach einer relevanten Korrektur kannst Du die Live-URL erneut testen und bei Bedarf eine erneute Verarbeitung anstoßen. Wie das funktioniert und welche Grenzen dabei gelten, erfährst Du im Ratgeber zur Indexierungsanfrage bei Google. Wiederholte Anfragen beheben allerdings keine fortbestehenden technischen oder inhaltlichen Ursachen.
Plane außerdem eine laufende Kontrolle ein. Besonders Produktpreise, Verfügbarkeiten, Veranstaltungen, Stellenanzeigen und redaktionelle Änderungsdaten können schnell veralten. Schema Markup ist deshalb keine einmalige Ergänzung, sondern Teil der technischen und redaktionellen Datenpflege.
Fazit
Schema Markup verbessert die maschinenlesbare Beschreibung einer Seite und kann sie für unterstützte Rich Results qualifizieren. Es ist aber weder ein Indexierungsbefehl noch eine Rankinggarantie. Der größte Nutzen entsteht, wenn indexierbare Inhalte, sichtbare Angaben, ein geeigneter Schema-Typ und eine verlässliche technische Ausgabe zusammenpassen.
- Fehlende Indexierung muss unabhängig vom Schema Markup diagnostiziert und behoben werden.
- Schema.org-Gültigkeit und Google-Eignung für Rich Results sind unterschiedliche Prüfziele.
- JSON-LD sollte sichtbare Inhalte korrekt abbilden, validiert und dauerhaft aktuell gehalten werden.
Bei komplexen technischen Befunden kann KAREON bei Auswahl, Implementierung und Prüfung strukturierter Daten unterstützen: Anfrage stellen.